
研究 / 01
InterviewDx
从 AI 辅助反馈与对话支架到独立面试练习
InterviewDx 以证据化反馈、候选人主导的对话和独立练习构成支架,帮助候选人完成面试准备,同时保留其对反馈的判断与作答责任。
- Inspect
- Discuss
- Practice
- 研究问题
- 在提供有用反馈与适应性支持的同时,AI 辅助面试训练如何避免取代候选人最终必须亲自完成的评价与作答工作?
- 研究路径
- 我们先通过两阶段形成性研究,理解求职者如何理解并使用面试反馈;再围绕证据化反馈、候选人主导对话和独立练习设计 InterviewDx;并在 40 人的随机组间前后测实验中,将其与开放式 AI 练习进行比较。
- 贡献
- InterviewDx 提出面向开放式面试练习的 AI 支架:让反馈主张可被检查,让候选人贡献的上下文塑造后续支持,并通过对无辅助作答的明确回交,把回答生成的责任交还给候选人。
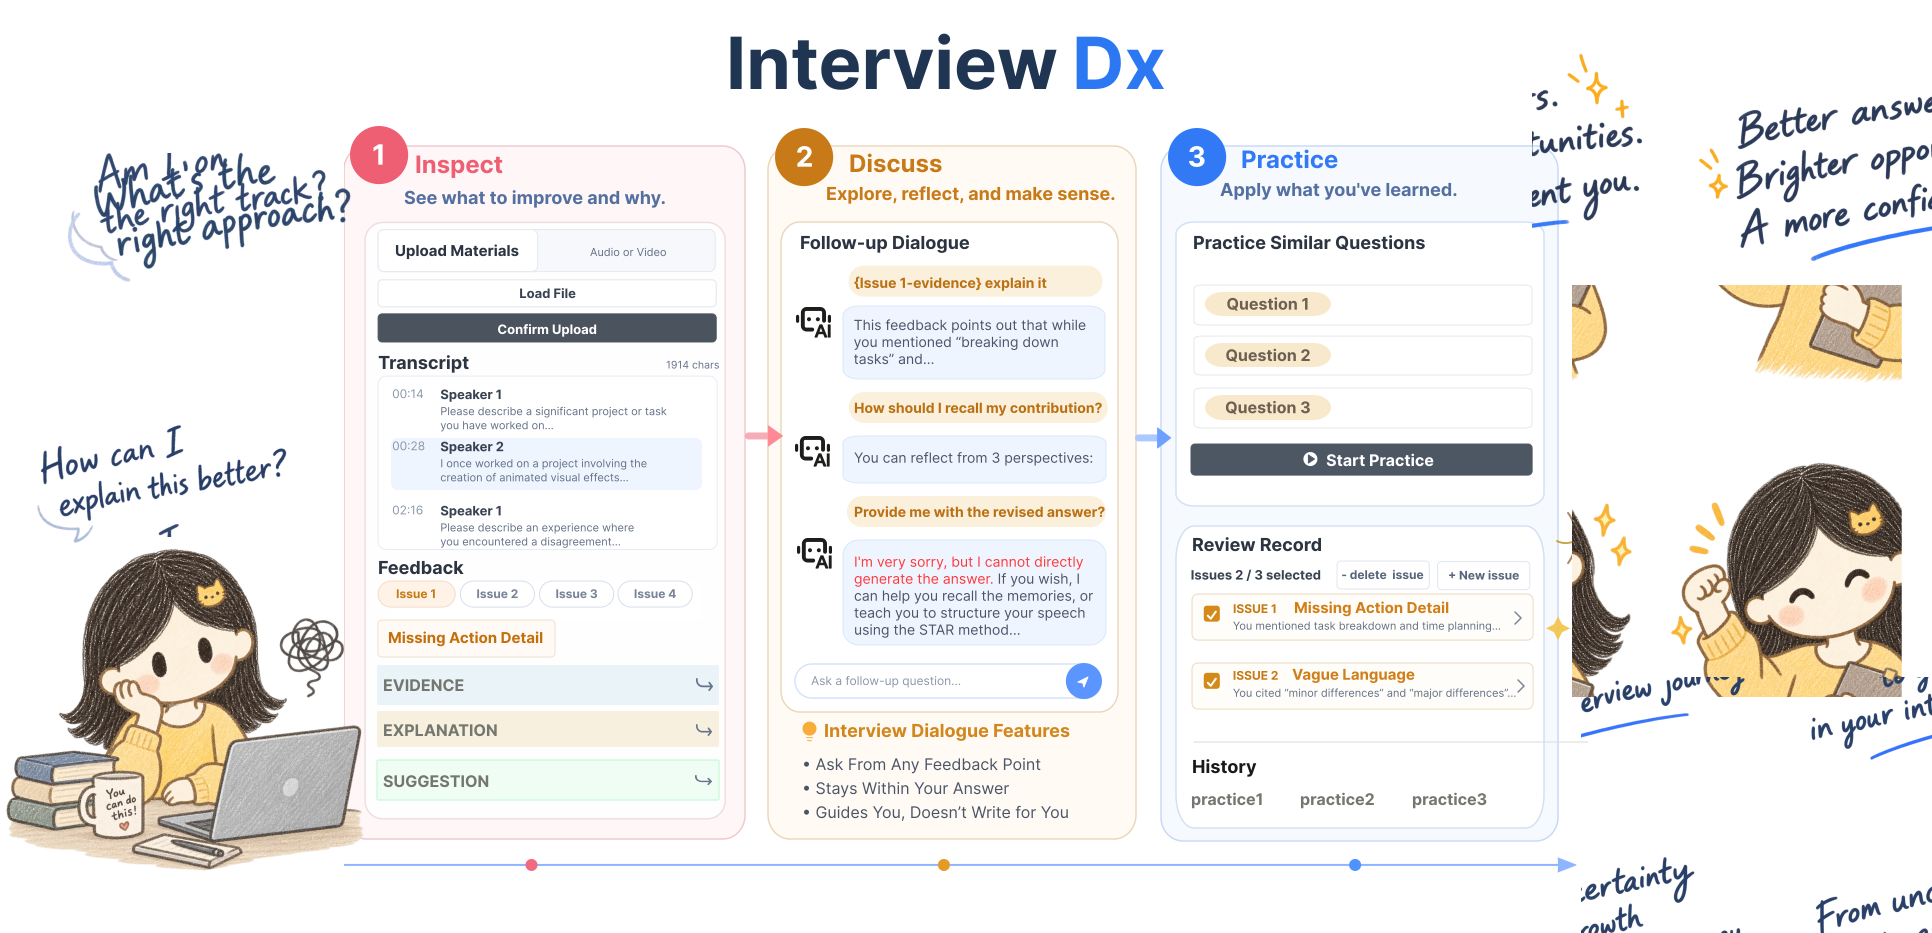
仅有反馈并不够
收到指导,并不等于候选人已经理解它、判断它是否相关,或能把所学迁移到自己的作答中。
面试练习要求候选人在压力下理解问题、提取相关经历,并把它们组织成连贯、基于经验的回答。结构化练习和反馈可以提升表现,但收到反馈并不保证候选人会主动评估或应用它。
大语言模型可以提供开放式反馈与对话,但更多帮助并不必然带来独立学习。当支持被撤走时,AI 辅助下的提升可能无法迁移;而开放式系统又可能给出泛化反馈,或把过多的交互主导负担交给用户。
因此,设计问题不只是如何给出更好的反馈,而是如何帮助候选人亲自处理反馈,并在没有 AI 辅助时完成作答。
系统架构
InterviewDx 把学习进程连接到具体的用户行动和系统组件。
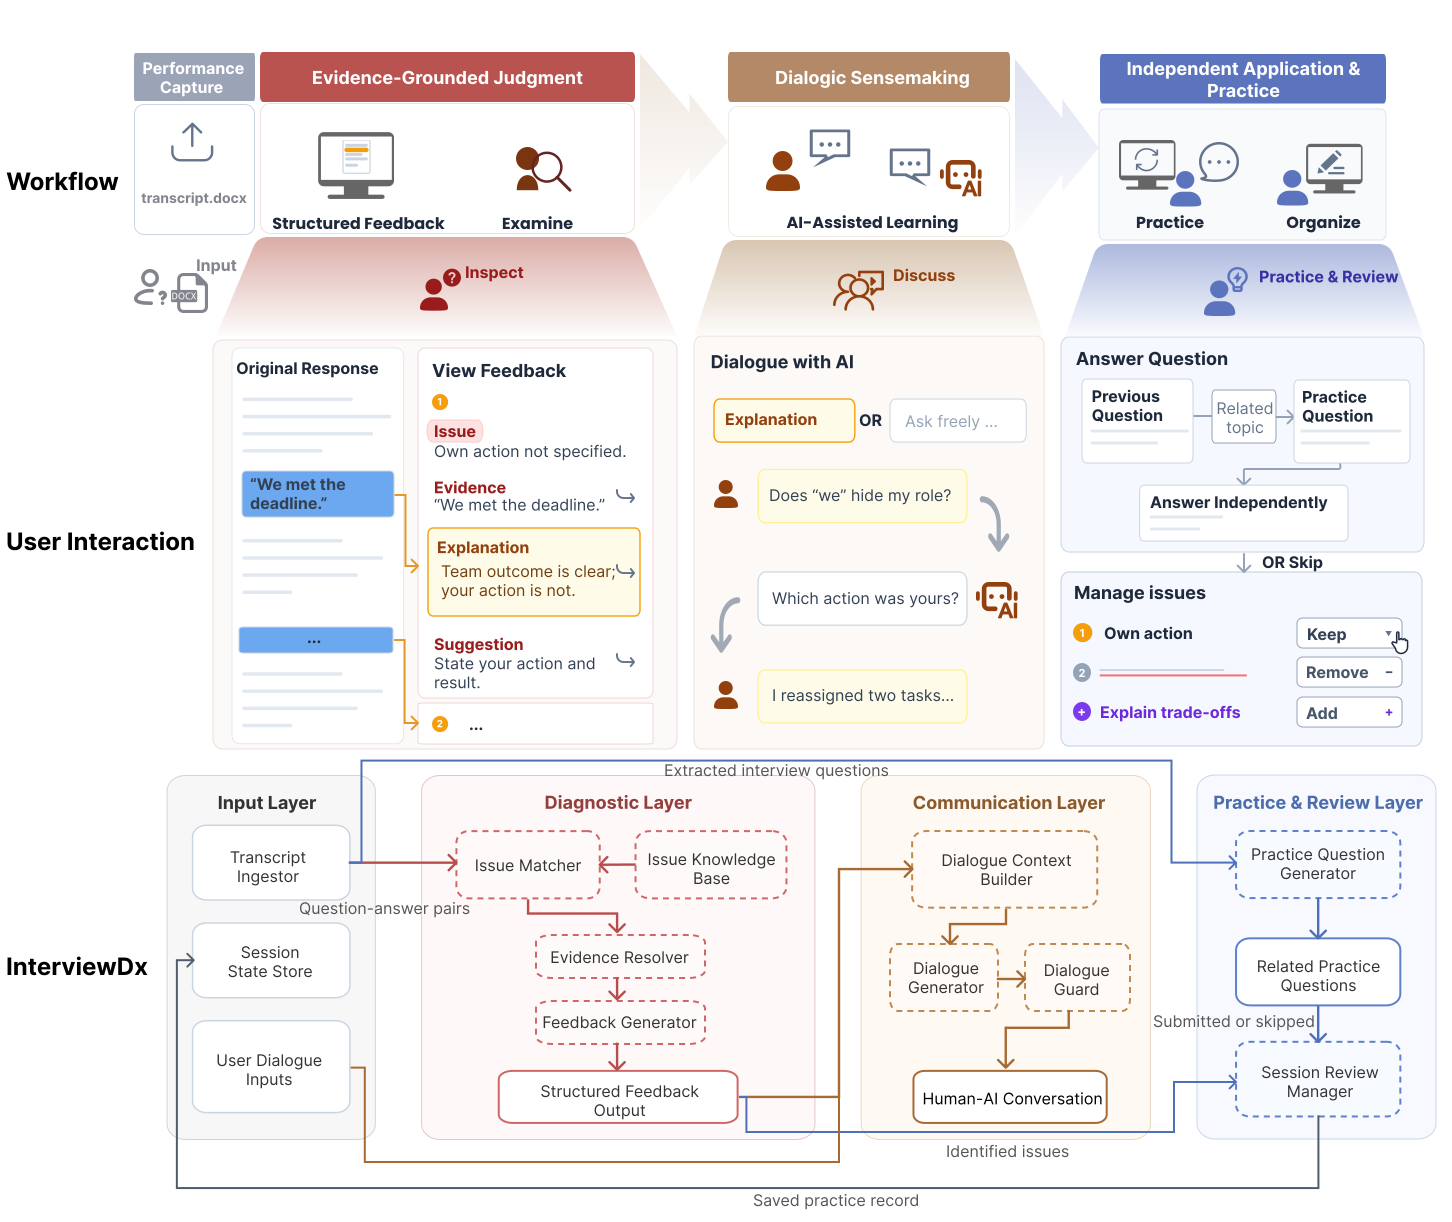
工作流
Performance Capture → Evidence-Grounded Judgment → Dialogic Sensemaking → Independent Application & Practice
用户交互
Input → Inspect → Discuss → Practice & Review
系统组件
InterviewDx 由输入层、诊断层、沟通层以及练习与复盘层组成。结构化反馈锚定在候选人的原始作答上;对话纳入候选人的问题与补充上下文;相关练习题再把作答生产交还给候选人。
设计原则
支架必须让反馈可检查、让对话由候选人驱动,并在随后的尝试中把作答责任交还回去。
证据化且可检查的判断
AI 判断应使用明确而稳定的评价维度,限定在正在审阅的作答范围内,并把每个问题连接到可观察证据。每个问题都应说明其重要性,并给出修改方向,但不替候选人决定是否接受该反馈。
候选人主导的对话理解
候选人应能质疑具体反馈、提出顾虑,并补充项目细节或岗位要求等上下文。后续支持应随候选人所问或所贡献的内容而调整,而不是一次把全部解释交付完毕。
独立应用与练习
系统应提供一次明确的后续作答机会,同时保留候选人自己生成回答的责任。这创造了应用反馈的空间,而不是用一份完整改写稿替代候选人的努力。
使用过程
界面让原始作答、AI 判断以及候选人随后的工作始终保持可见连接。
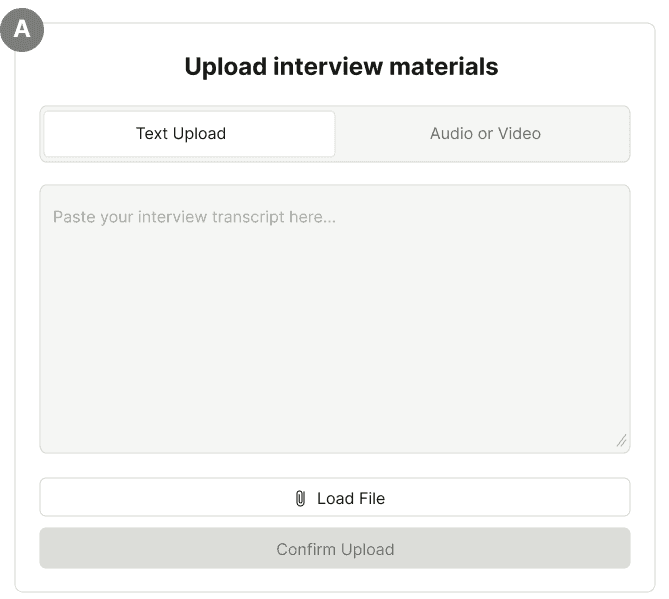
A
上传材料
候选人提供自己的面试材料。
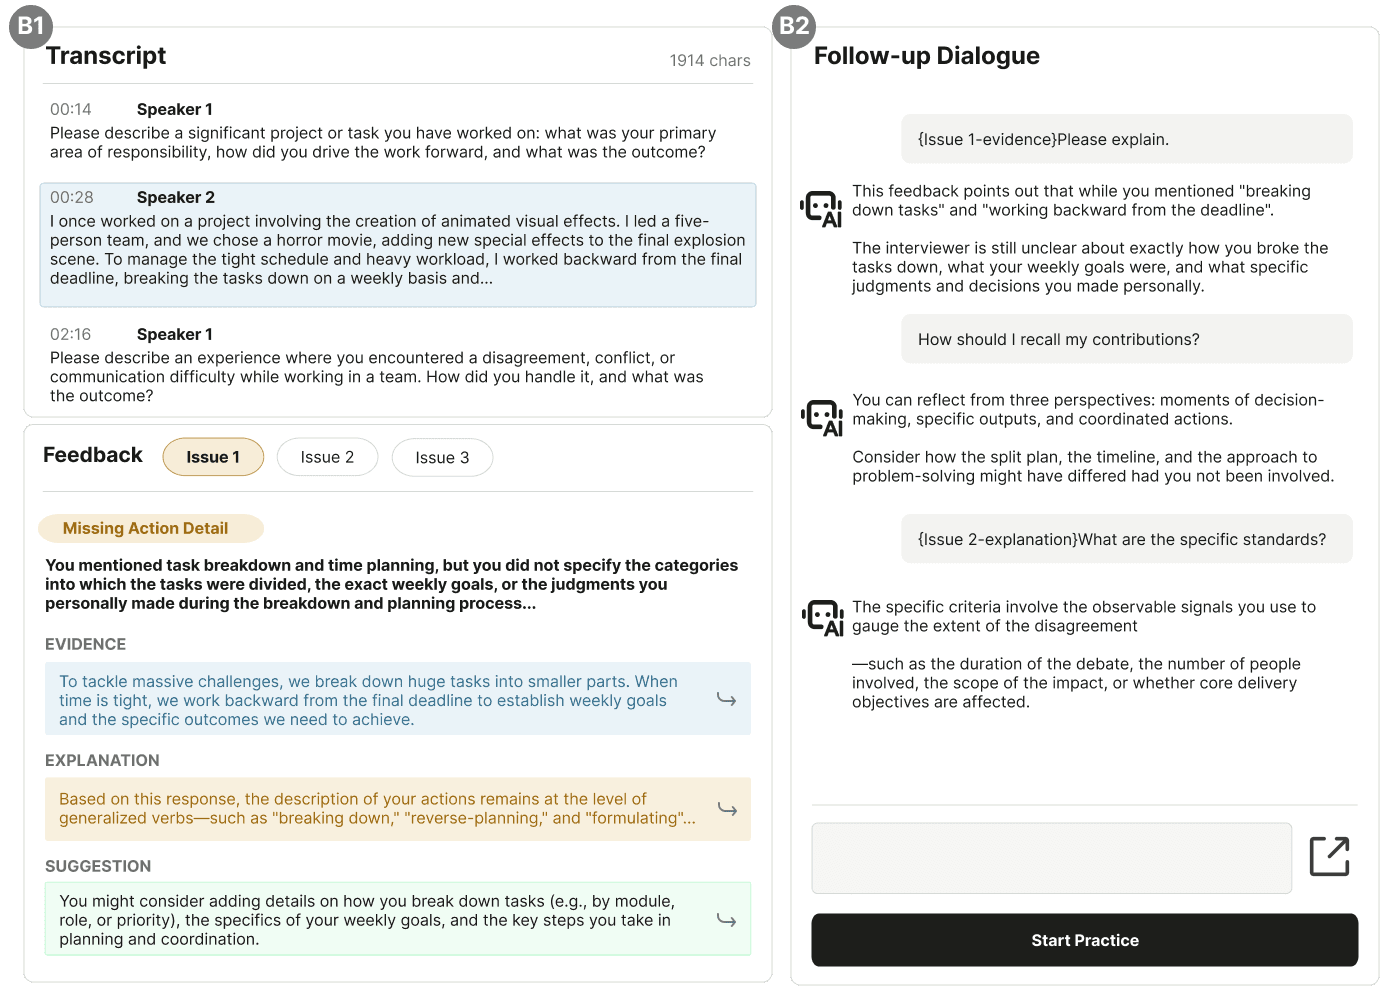
B1–B2
检查问题与后续对话
原始作答与结构化反馈并置,反馈包含四个部分:Issue、Evidence、Explanation 和 Suggestion。候选人可以针对某一反馈成分提问,也可以自行组织问题,同时继续查看原始作答与反馈。
C
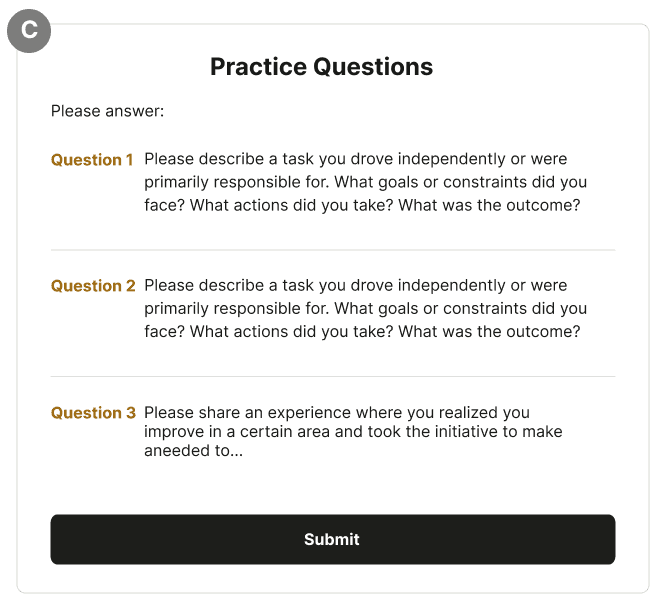
独立练习
候选人独立回答练习题,此时无法访问反馈或对话。
D
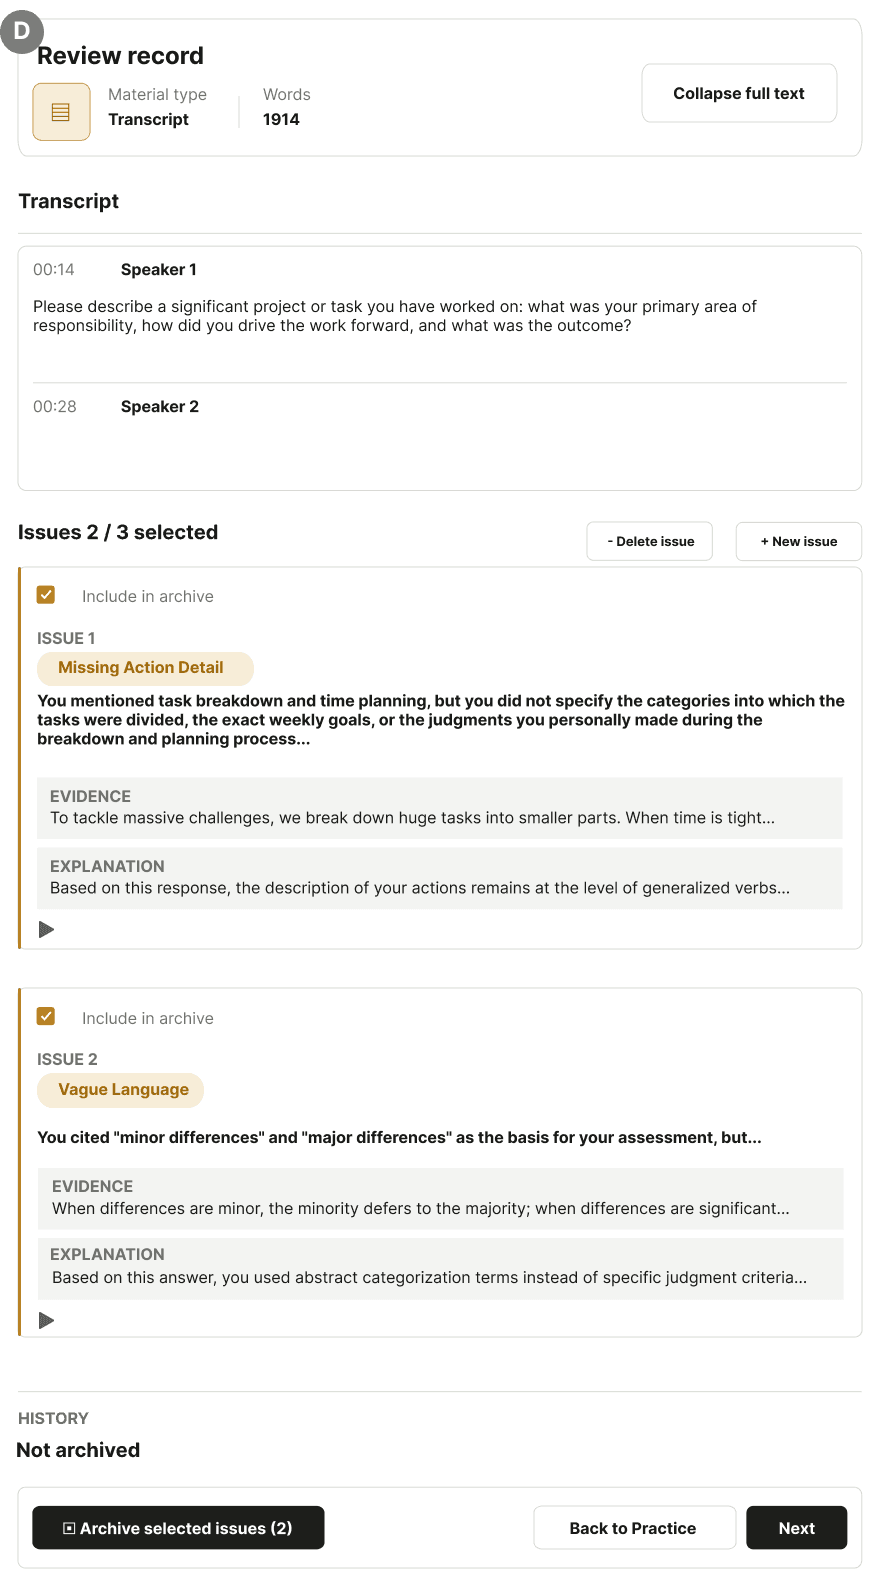
复盘整理
候选人复盘并整理希望保留在练习记录中的问题。
研究设计
我们在保持底层语言模型不变的前提下,将 InterviewDx 与开放式 AI 练习进行比较。
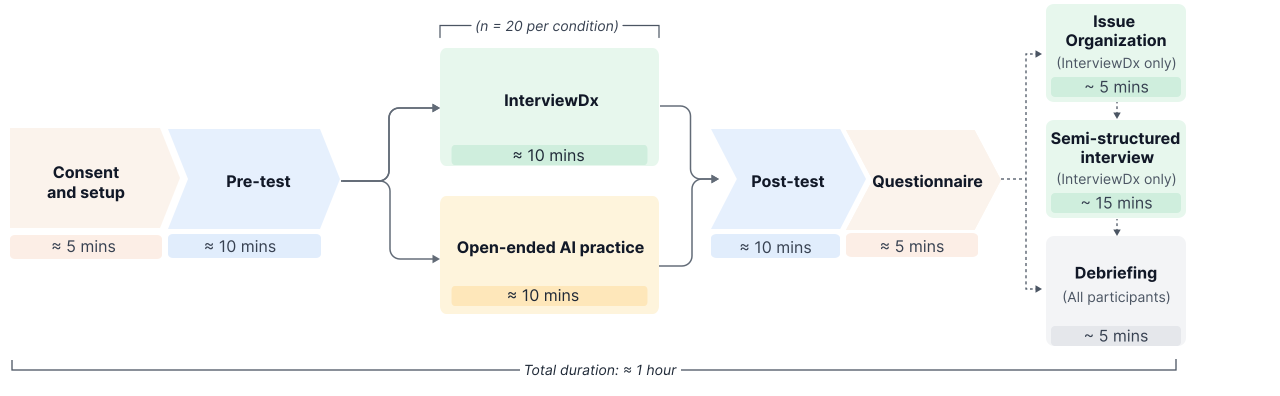
两种条件使用同一冻结语言模型,并要求至少三轮由参与者撰写的对话。参与者在前测完成三道标准化面试题,在后测再完成三道。后测作答在没有 AI 辅助的情况下独立完成。
共同流程
知情同意与准备 → 前测 → AI 支持练习 → 后测 → 问卷 → 说明。
InterviewDx 独有步骤
InterviewDx 组另外完成问题整理(Issue Organization)和半结构化访谈。
主要发现
InterviewDx 改善了参与者对 AI 支持的体验,并在独立后测表现上呈现正向优势。
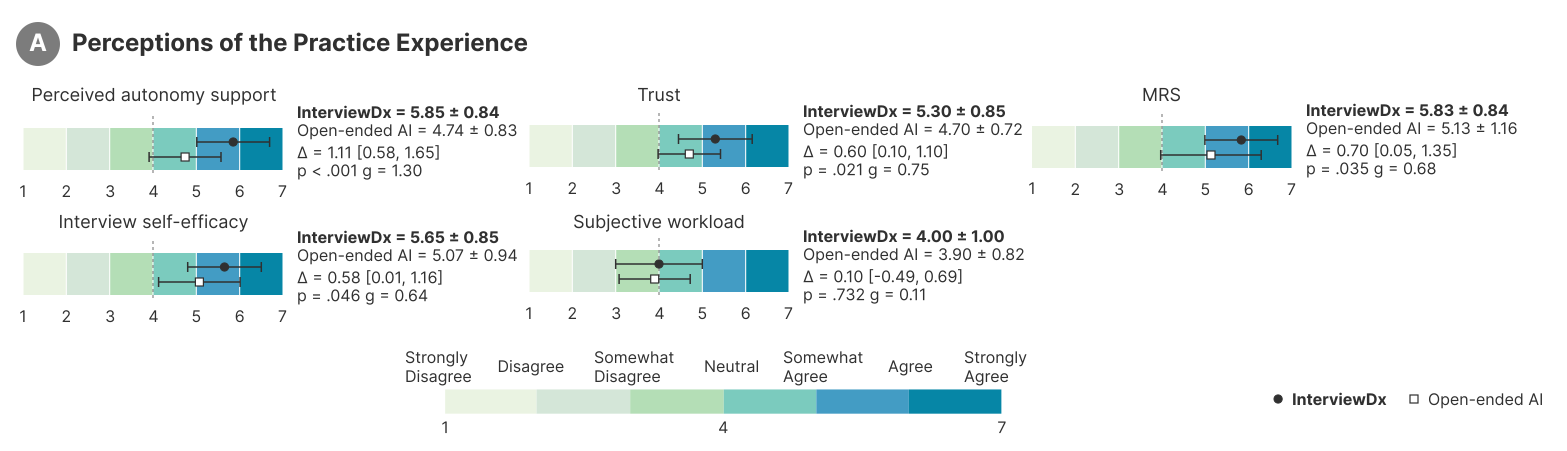
参与者认为 InterviewDx 更支持自主性、信任、元认知反思和面试自我效能。
证据
最大差异出现在感知自主性支持:Δ = 1.11,95% CI [0.58, 1.65],Hedges' g = 1.30,p < .001。信任、元认知反思支持和面试自我效能同样偏向 InterviewDx,而主观负荷没有明确差异。自主性支持:InterviewDx 5.85 ± 0.84,开放式 AI 4.74 ± 0.83;信任:5.83 ± 0.84 vs 5.13 ± 1.16;MRS:5.30 ± 0.85 vs 4.70 ± 0.72;自我效能:5.65 ± 0.85 vs 5.07 ± 0.94;负荷:4.00 ± 1.00 vs 3.90 ± 0.82。
解释
主要差异在于参与者对支持质量与结构的体验,而不是负荷被减轻。
InterviewDx 在独立评分的后测表现上呈现正向优势。
证据
基线调整估计为 +0.234 分,95% CI [-0.013, 0.481],p = .062,partial η² = .091。
解释
在撤去 AI 辅助后,InterviewDx 组的后测表现仍高于开放式 AI 练习。
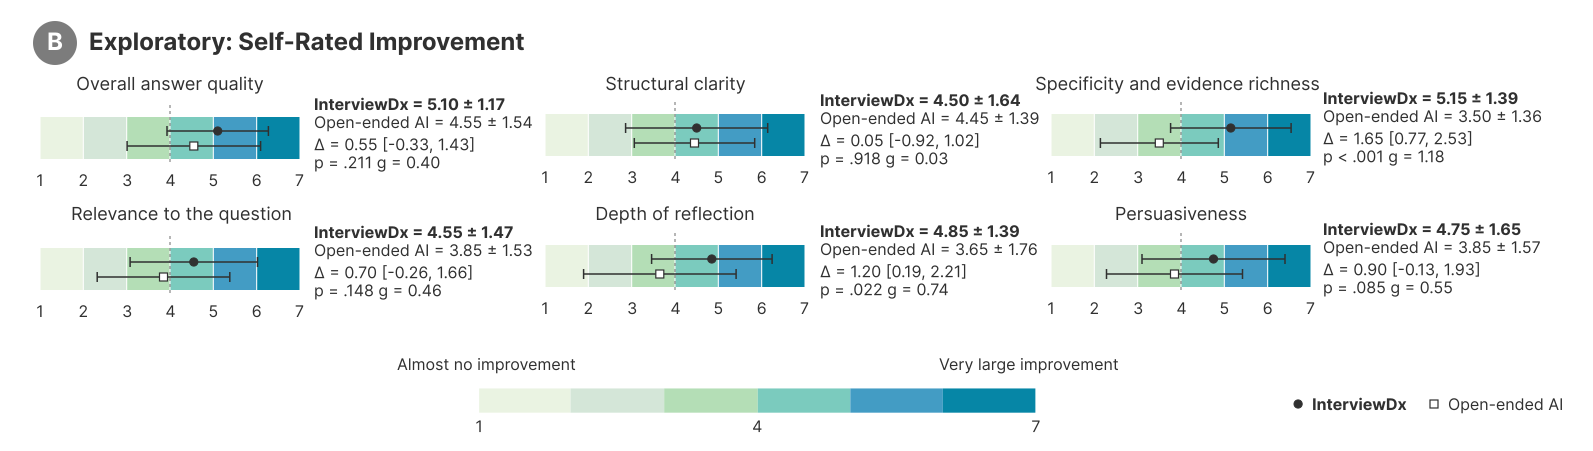
InterviewDx 在具体性、证据丰富度和反思深度上获得更高评价。
解释
参与者感到反馈更贴合作答本身,也更能帮助他们把问题想清楚,而不是只得到一份笼统评价。
人们如何使用对话
与开放式 AI 练习相比,InterviewDx 的对话包含更广的会话行动范围。
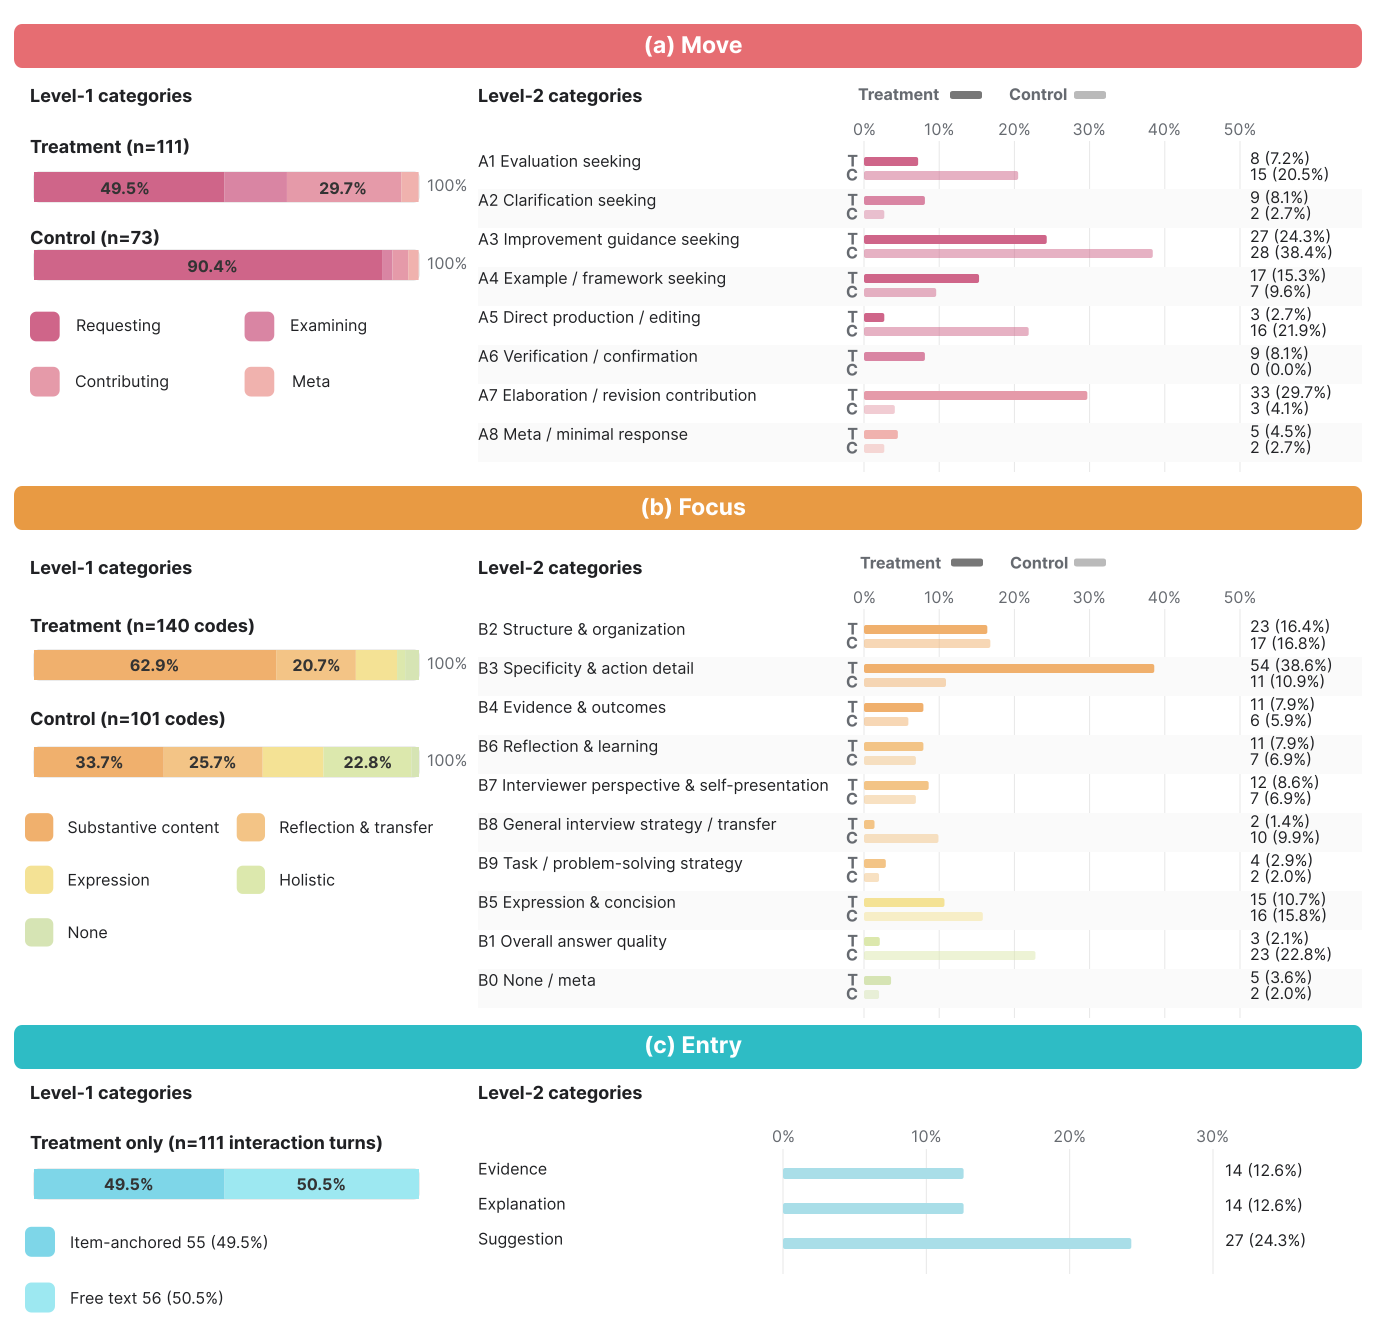
开放式 AI 对话以请求 AI 支持为主,而 InterviewDx 包含更多反馈检查和参与者贡献。
证据
在 184 轮参与者撰写的对话中,开放式 AI 的请求占比为 90.4%,InterviewDx 为 49.5%。参与者贡献为 29.7% vs 4.1%;对既有反馈的检查为 16.2% vs 2.7%。在 InterviewDx 内部,条目锚定与自由文本入口几乎同样常见:55 vs 56 轮。结构化反馈也被明确检查:13/20 场中的 18 轮涉及澄清或核实,其中 16/18 从具体反馈项开始。参与者贡献出现在 33/111 轮 InterviewDx 对话中,往往涉及具体经历、行动或修改,而不是单纯请求更多 AI 输出。
解释
当反馈成为可检查的对象,并且对话可以从具体条目进入时,候选人更常去审视判断并贡献自己的材料,而不是持续索取下一段 AI 输出。
研究贡献
反馈锚定
让 AI 反馈可被检查,而不是自我成立。
主张始终绑定到可观察的作答证据、明确标准、解释与修改方向,供候选人审视与质疑。
对话支架
让候选人参与决定下一步应提供何种支持。
对话使缺失的上下文与学习需求在初始反馈之后显现,从而使支持部分由候选人驱动、并具有权变性。
独立迁移
把产出责任交还给候选人。
随后的无辅助作答把独立生成回答纳入支架本身,而不是假定理解反馈就已足够。