
研究 / 03
DynaMER
面向多模态情感识别的动态表征增强方法
在语言解码之前显式建模视觉和声学中的时变情感证据。
- 研究问题
- 多模态情感识别如何显式保留短时视觉与声学动态,而不是依赖语言模型从压缩后的语义表征中重新推断这些变化?
- 研究路径
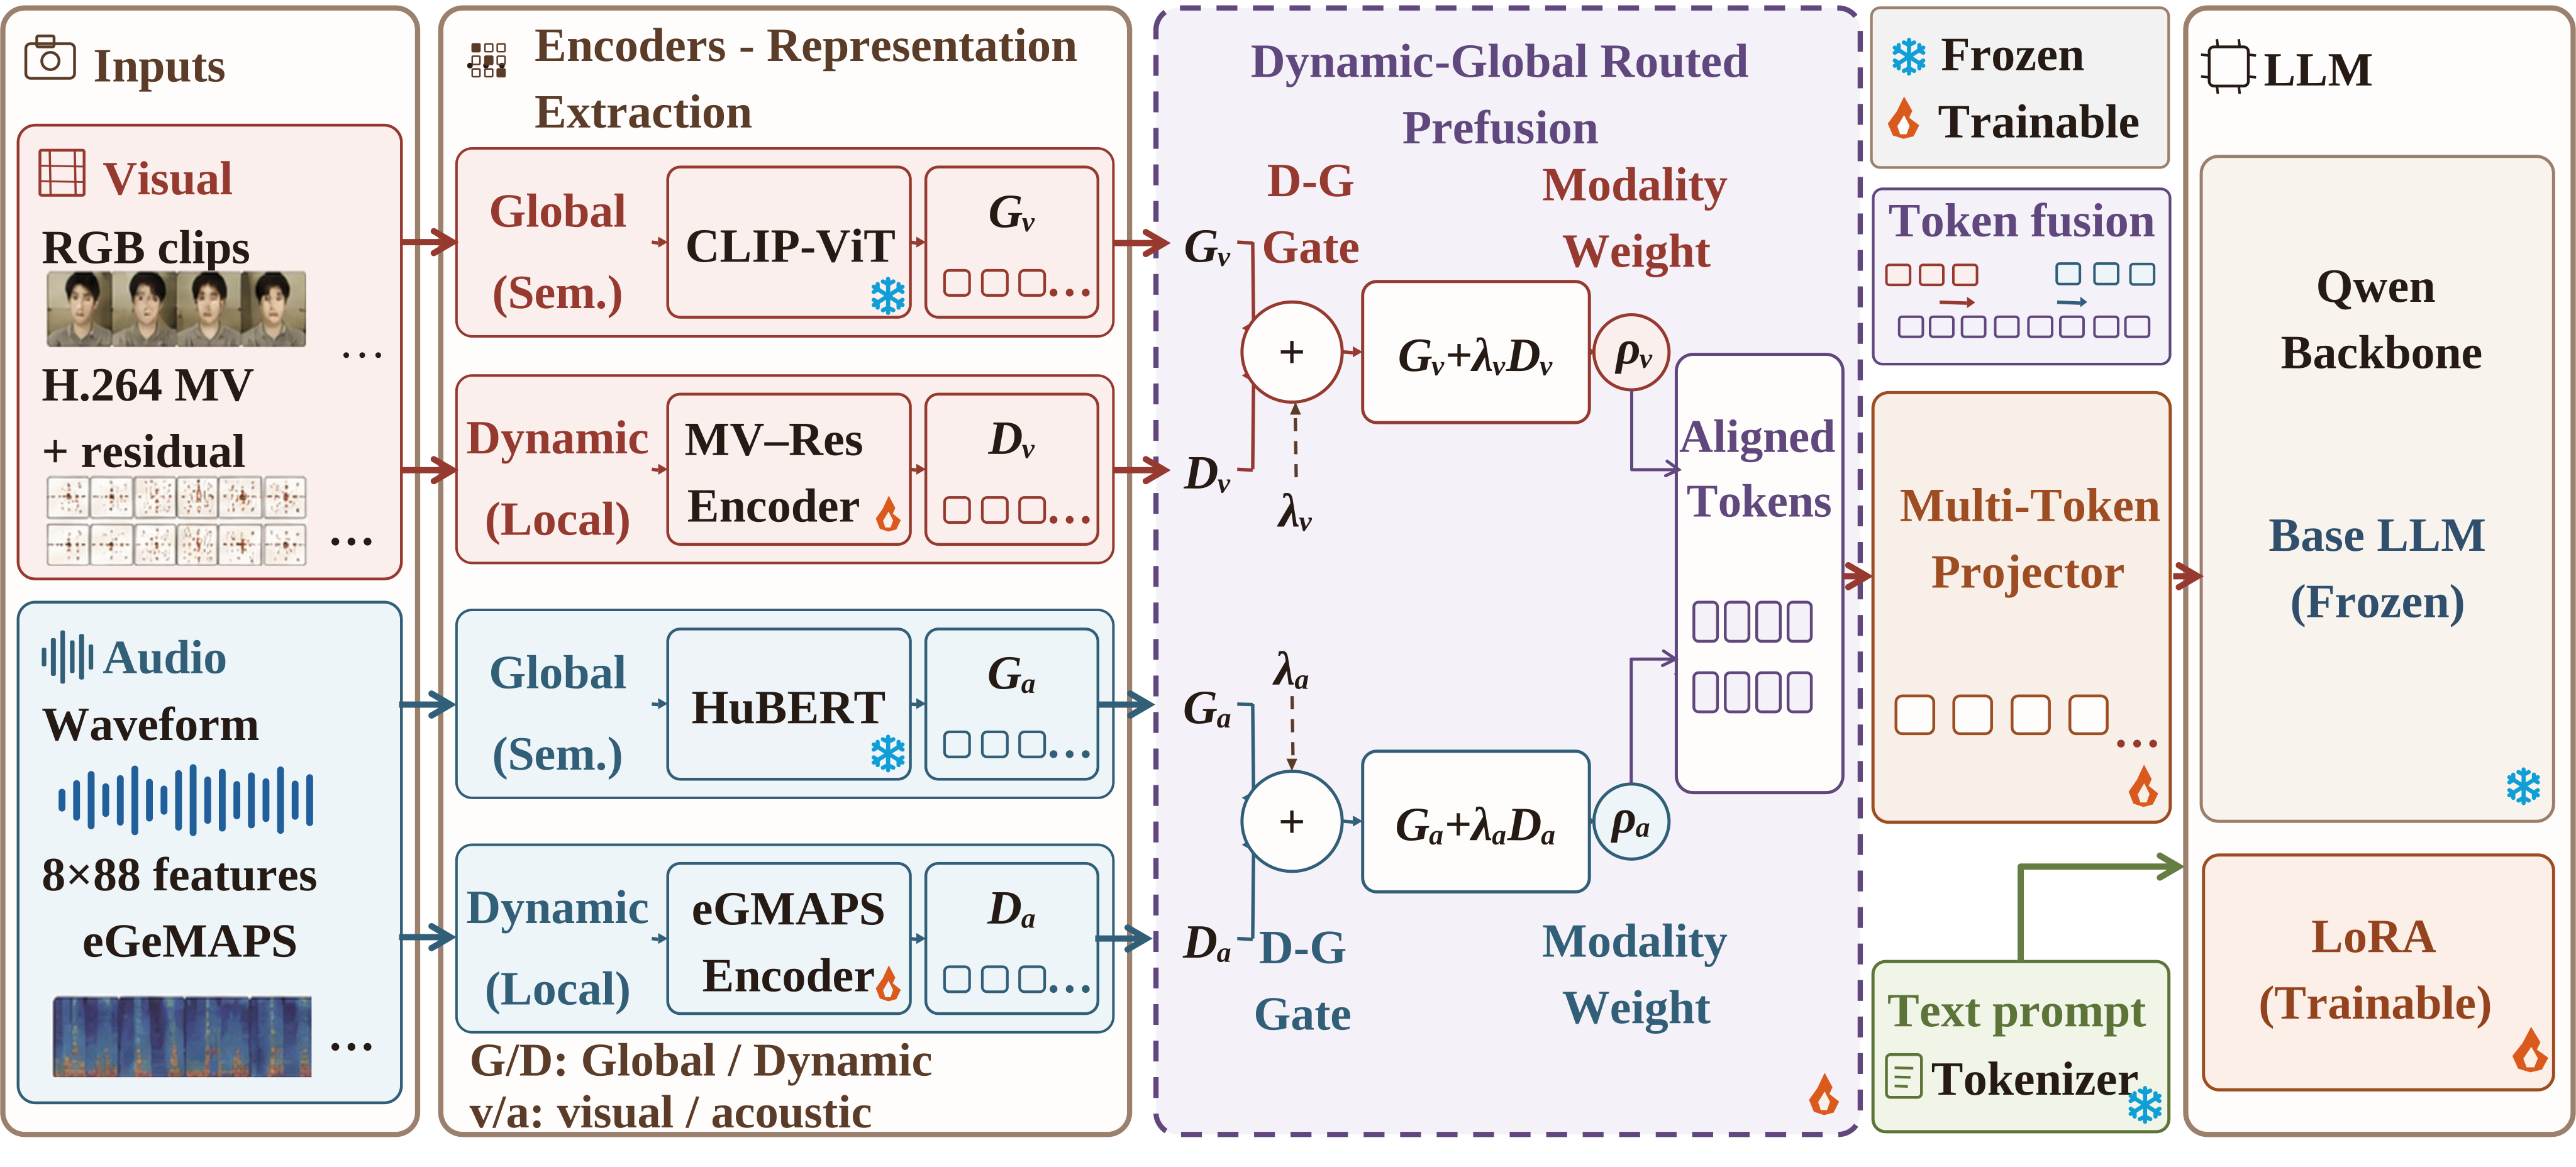
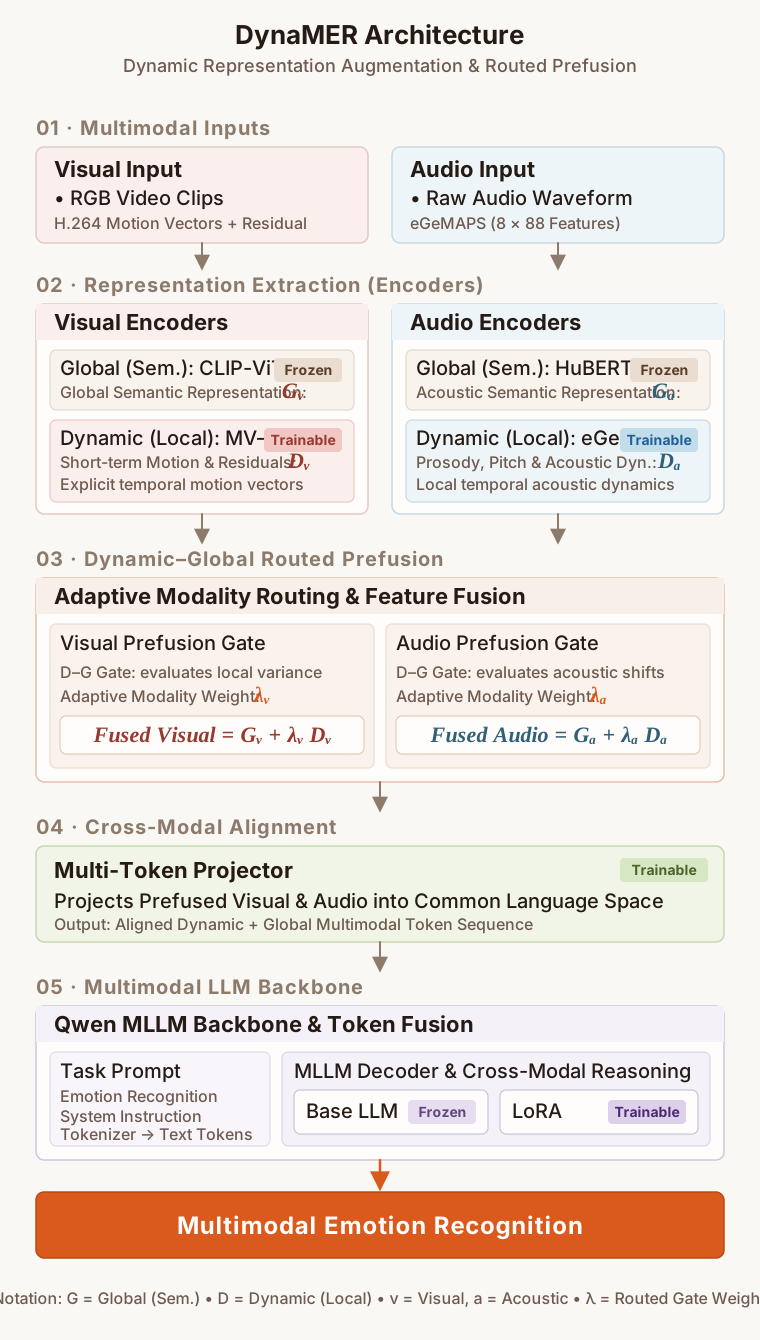
- DynaMER 为视觉和声学分别构建动态表征,并在多模态语言解码之前将其与全局表征进行自适应融合。
- 贡献
- 一套动态表征增强框架,将具有时间判别性的视听证据显式提供给多模态融合模块。
研究问题
多模态情感不仅取决于“出现了什么”,也取决于视觉和声学信号“如何随时间变化”。
现有面向情感理解的多模态大语言模型能够从视频和音频中获得高层语义信息,但短时动态信息可能在表征过程中被压缩,或需要由语言模型骨干网络隐式恢复。
然而在情感识别中,面部运动、局部外观变化、韵律、响度、音高和声音质量等信号本身会随时间变化。
DynaMER 因此研究:是否可以在语言解码之前,直接将这些动态信息建模为显式表征。
研究路径
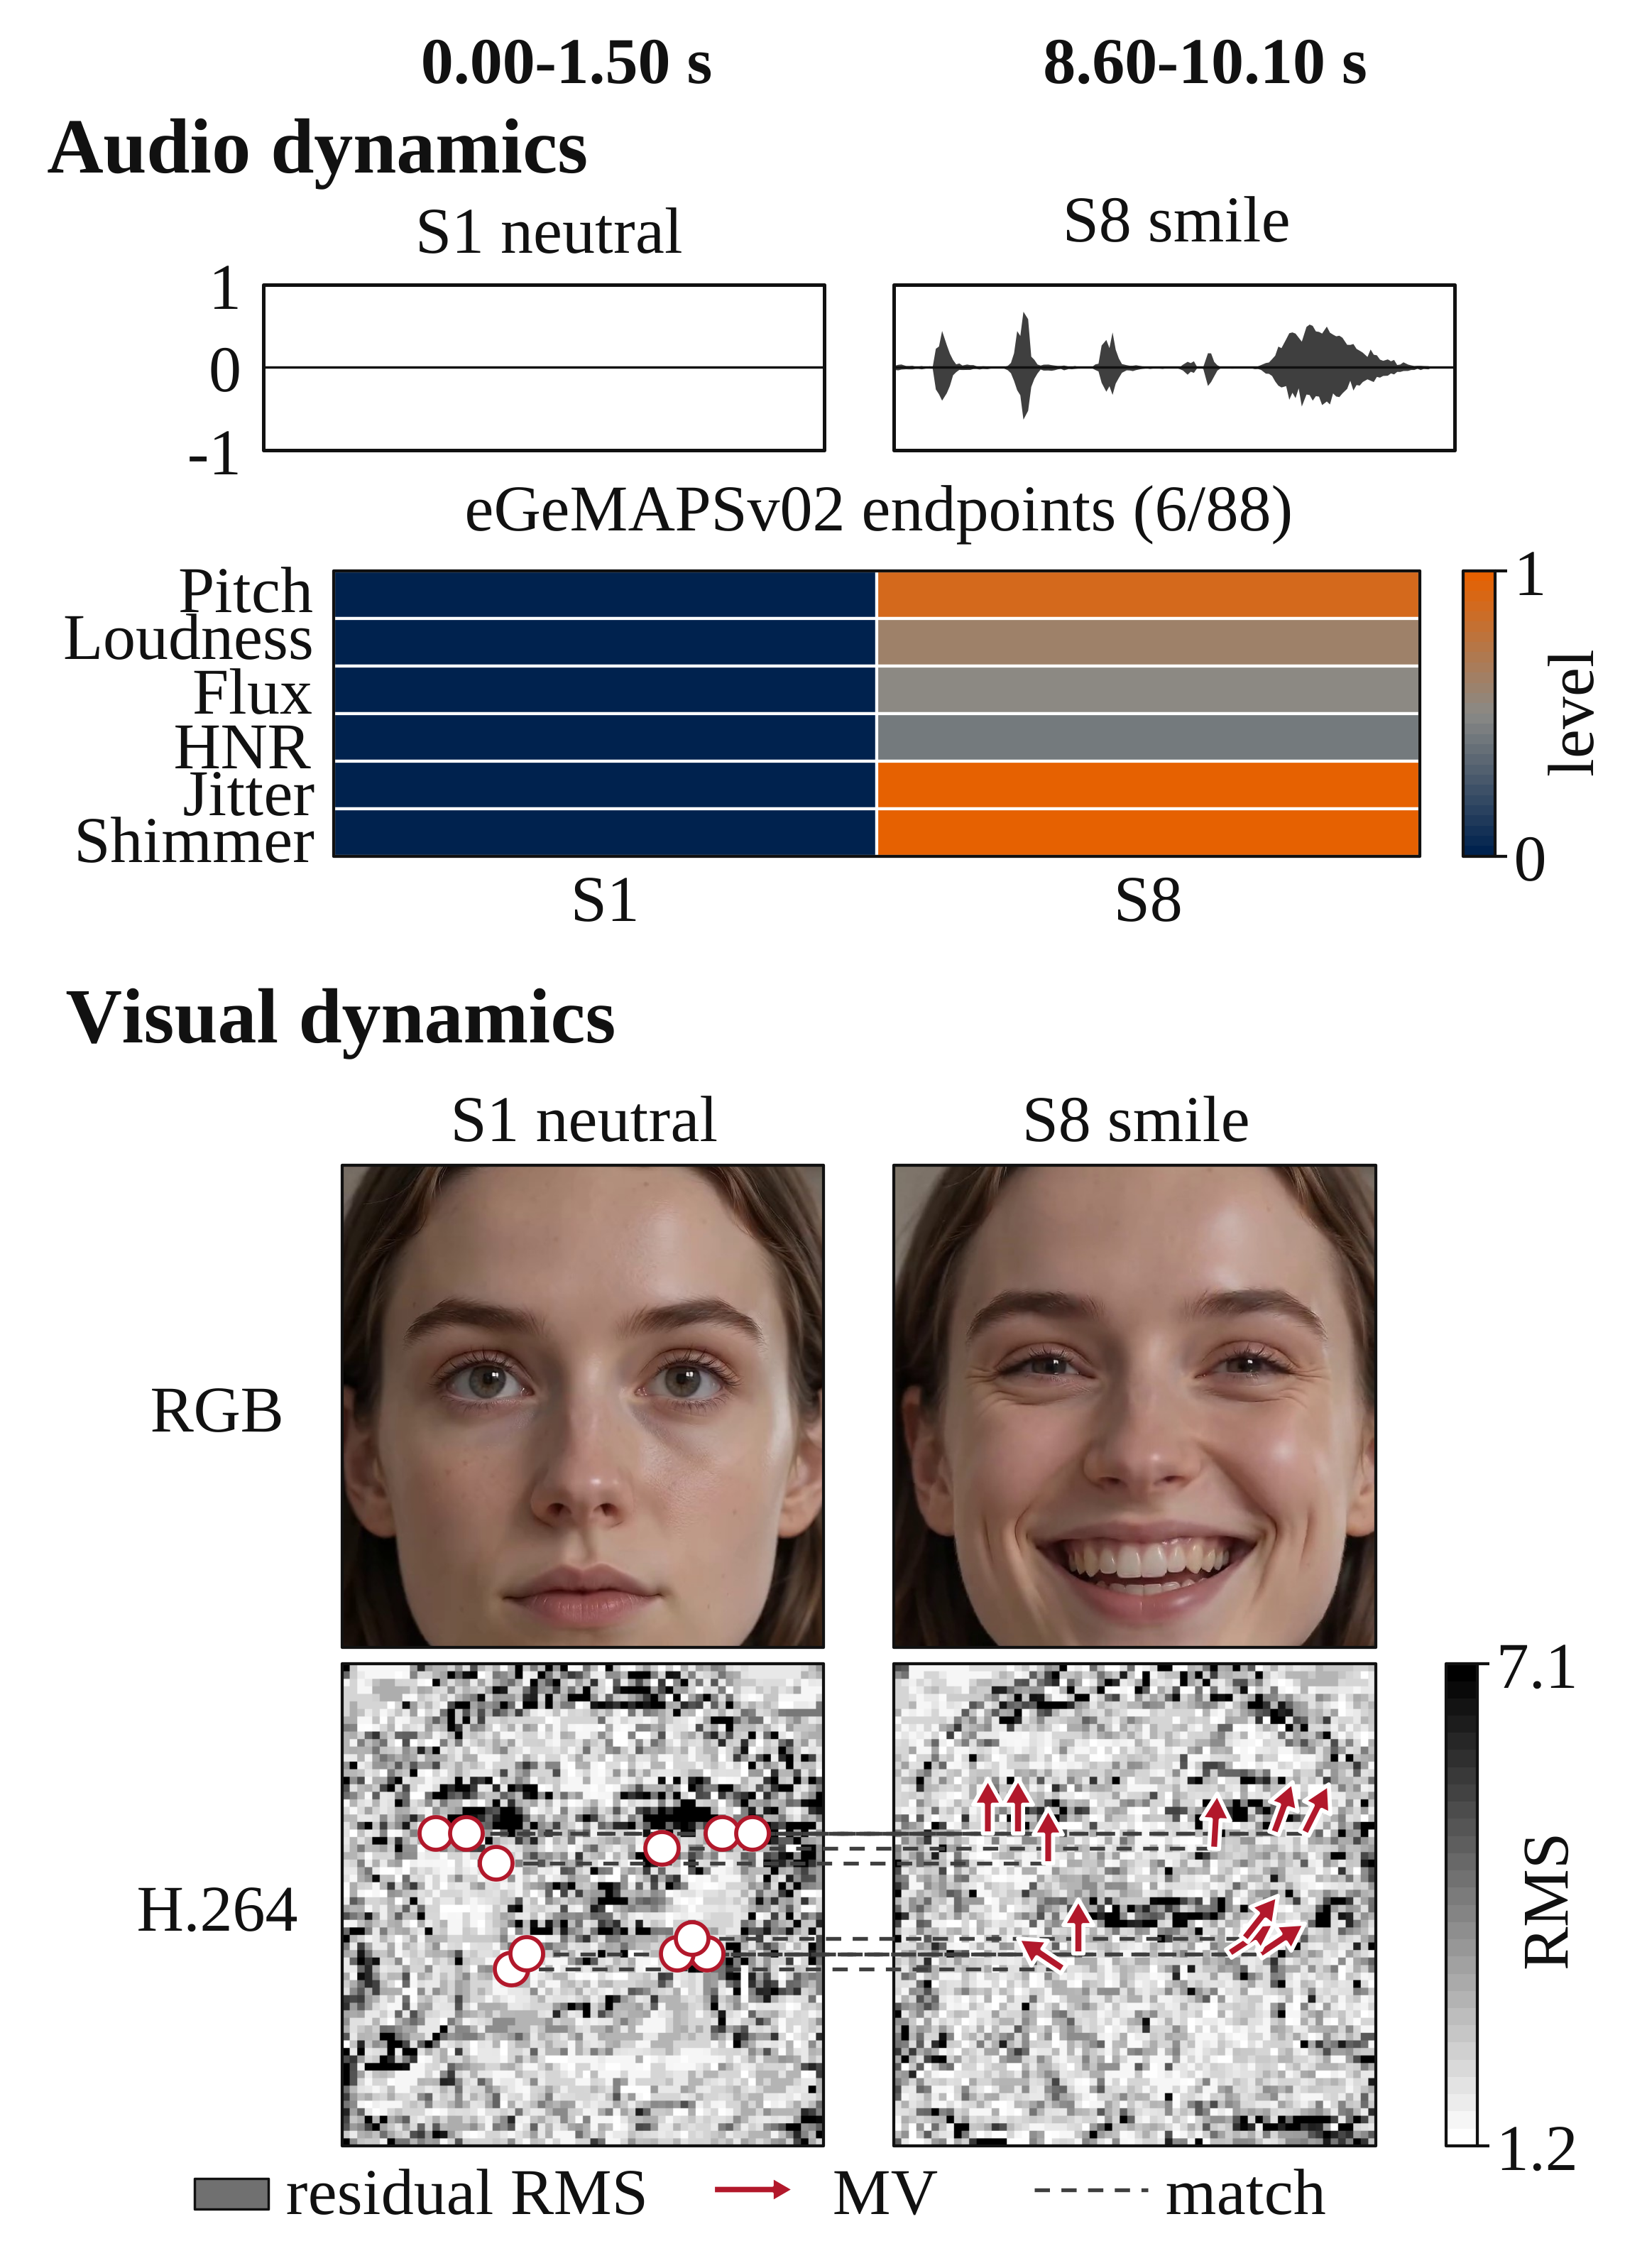
DynaMER 将每个模态的信息拆分为两种互补视角。
全局表征(Global Representations)负责捕获高层语义上下文。
动态表征(Dynamic Representations)则显式编码可能在语义压缩后难以恢复的短时变化信息。
在视觉侧,DynaMER 使用视频编码中的运动向量与预测残差描述局部运动及外观变化。
在声学侧,系统建模与韵律和声音质量相关的声学描述符随时间的变化。
随后,这些时间对齐的表征通过 Dynamic–Global Routed Prefusion 进行融合,再进入语言模型接口。
研究方法
动态证据构建
视觉与声学信号首先被划分为时间对齐的窗口。全局编码器负责语义上下文,而动态编码器负责建模运动、外观变化与短时声学变化。
Dynamic–Global Routed Prefusion
在每个模态内部,DynaMER 首先估计动态证据应在多大程度上增强全局表征;随后再对视觉和声学信息进行样本级自适应分配。
控制式评估
实验设计将整体基准性能与机制验证区分开,并通过动态证据、路由机制与时间结构等控制实验分析模型为何有效。
主要发现
显式动态证据提供了仅依赖全局表征时无法充分获得的信息。
解释
短时运动、外观变化和声学变化携带与情感相关的重要线索,而这些线索在只保留高层语义表征时可能被削弱。
自适应路由具有作用:不同样本和不同模态中的动态证据不应被固定地等量处理。
解释
动态证据的重要性会随样本与模态而变化,因此相比固定或等量融合,自适应分配更适合这一任务。
显式建模领域原生证据,可以降低系统对更大语言模型骨干规模的依赖。
解释
当系统在更早阶段显式提供具有时间判别性的视听证据时,就可以降低仅依赖更大语言模型骨干去恢复情感动态信息的需求。
研究贡献
表征
面向视觉与声学时间动态的显式动态表征。
融合
用于自适应融合全局与动态证据的 Dynamic–Global Routed Prefusion。
评估
一套用于区分整体性能增益以及动态证据、路由机制和模型容量影响的控制评估框架。